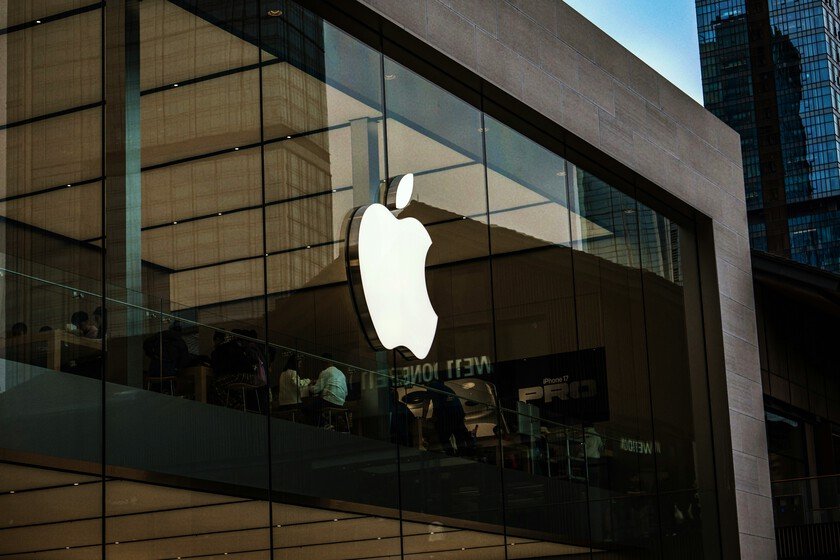
Apple quiere que sus usuarios usen todo el rato la nueva Siri AI en sus dispositivos. Apple lo vende como su gran remontada en IA. Pero de puertas para adentro, alguien ha mirado el Excel (o Numbers, en su caso) de gastos en IA de sus empleados y ha empezado a meterle la tijera a los presupuestos diarios de tokens que los equipos de Apple pueden usar para mejorar su trabajo.
Este recorte en el presupuesto de tokens para sus empleados no es cosa solo de Apple. Muchas de las empresas que hasta hace solo unos meses invitaban a sus empleados a usar la IA en su trabajo, han recibido ya su primera factura de esos tokens consumido. El susto ha debido ser tan grande que les han cerrado el grifo.
Apple mete la tijera a los tokens. De acuerdo a lo publicado por Bloomberg, el mes pasado Apple redujo de forma discreta el límite diario de uso de tokens de algunos ingenieros de 300 a 200 dólares. Ahora, la compañía de Ternus estudia rebajarlo todavía más y dejarlo en 100 dólares para determinados equipos.
Fuera de ingeniería, algunos grupos de empleados pasarían de 100 dólares en tokens a 25 dólares diarios. Quien necesite más puede pedir una excepción y se estudiará su uso. Los empleados de Apple disponen de acceso a Claude, ChatGPT y Gemini. Aun así, algunos equipos ya habrían recibo la consigna de usar modelos más baratos o que funcionen de forma local en el propio dispositivo.

¿Tan cara es la factura? Este recorte presupuestario para el uso de IA entre su plantilla llama la atención por venir de la tecnológica con mayor capitalización del mercado. ¿Si Apple no puede pagar la barra libre de tokens para sus empleados, quién puede?
Según sus cuentas, la compañía gastó 45.765 millones en I+D en su último ejercicio, un 32% más que en el anterior. Apple atribuye esa subida en parte a la inversión en IA. Entonces, ¿por qué recortar? Empleados citados por Bloomberg sostienen que «pocos trabajadores utilizaban la totalidad de su asignación diaria de 300 dólares», por lo que el ahorro real puede ser mínimo. Otros empleados manifestaban su temor a que esta limitación presupuestaria pueda ser la antesala de mayores recortes o posibles despidos, como está sucediendo en otras empresas tecnológicas.
Nvidia piensa justo lo contrario. Jensen Huang lo dejó claro en el podcast All-In. Le preocuparía mucho que un ingeniero con 500.000 dólares de sueldo gastara menos de 250.000 dólares en tokens de IA. Cuando le preguntaron si Nvidia gasta unos 2.000 millones al año en tokens para sus ingenieros, el CEO respondió: «Lo estamos intentando».
Las declaraciones de Huang tienen su lógica. Nvidia vende los chips donde se ejecutan esos modelos, por lo que cada token que se quema supone un poco más de inversión en potencia de cómputo y más ventas para sus chips. En Cupertino, que solo pagan la factura, el mensaje es muy diferente.
Apple no es la primera. El frenazo en el fenómeno conocido como tokenmaxxing viene de meses atrás. En Meta hubo una carrera interna por ser quien más tokens gastaba. En Amazon cerraron un ranking parecido en mayo. Su memorando posterior desaconseja el tokenmaxxing, pero la empresa asegura que no ha puesto límites.
En Microsoft, un solo empleado llegó a quemar 28.000 dólares en tokens en solo un mes. Microsoft reaccionó. Su vicepresidente Jay Parikh escribió en un correo interno al que tuvo acceso 404 Media que «el tokenmaxxing no es lo que estamos optimizando».
Revolut cambia de modelo. Con las facturas de los tokens en el punto de mira, algunas empresas buscan otra salida. Revolut ha puesto a unos 2.000 ingenieros a programar por defecto con GLM, un modelo chino de pesos abiertos. Sus parámetros son públicos y se pueden ejecutar en servidores propios, lo cual contribuye a reducir considerablemente el coste en tokens.
El responsable de infraestructura de Revolut, David Abitbol, contó que pagan una décima parte de lo que cuestan los modelos de frontera. Además, la factura es fija y no sube con cada petición. Antes, los 300 dólares mensuales por ingeniero para Claude Code no duraban todo el mes, ahora el límite de consultas la definen sus propios servidores.
En Xataka | Del «tokenmaxxing» hemos pasado al «tokenwasting»: el nivel de malgasto en IA está alcanzando cotas inéditas
Imagen | Unsplash (wang binghua)
